Intel Arc B580 Jalankan Model AI 125B 3x Lebih Cepat dengan XeStrata
- Dok. ASRock
GadgetVIVA - Pengujian terbaru terhadap kartu grafis Intel Arc B580 menunjukkan bahwa efisiensi pemrosesan kecerdasan buatan (AI inference) tidak hanya bergantung pada spesifikasi perangkat keras semata. Melalui pengujian menggunakan mesin pemroses open-source XeStrata, kartu grafis berbasis arsitektur Battlemage ini mampu menjalankan model Large Language Model (LLM) berkapasitas 125 miliar parameter dengan kecepatan mencapai 31,1 tokens per second.
Capaian tersebut melonjak drastis hampir tiga kali lipat dibandingkan pengujian menggunakan mesin Strata standar yang hanya mencatatkan 10,9 tokens per second. Menariknya, lompatan performa generasi teks hingga 185 persen ini didapat tanpa mengubah komponen kartu grafis sama sekali. Hal ini membuktikan betapa krusialnya peranan optimasi perangkat lunak dalam ekosistem AI lokal harian.
Optimasi Perangkat Lunak Melejitkan Throughput Generasi Teks
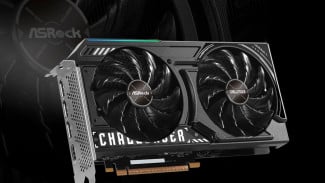
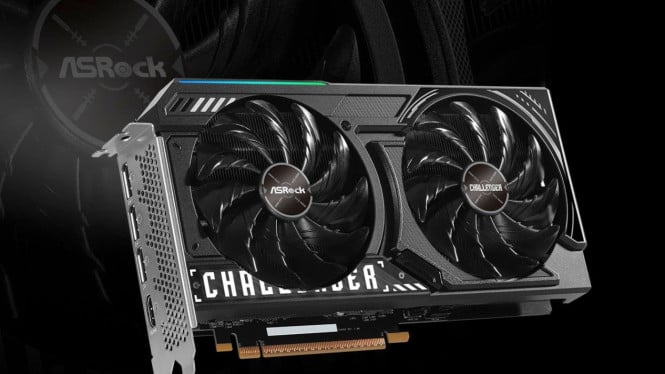
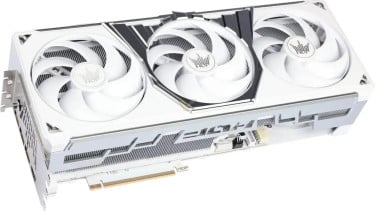
Pengujian yang dipublikasikan oleh media teknologi Jepang, PC Watch, menggunakan unit ASRock Intel Arc B580 Challenger 12GB OC. Dalam skenario uji coba tersebut, model bahasa yang dijalankan adalah Qwen3.8-Flash-Next. Konfigurasi model dikirimkan menggunakan metode kuantisasi IQ3_S, context window sebesar 64K token, serta 8-bit KV cache.
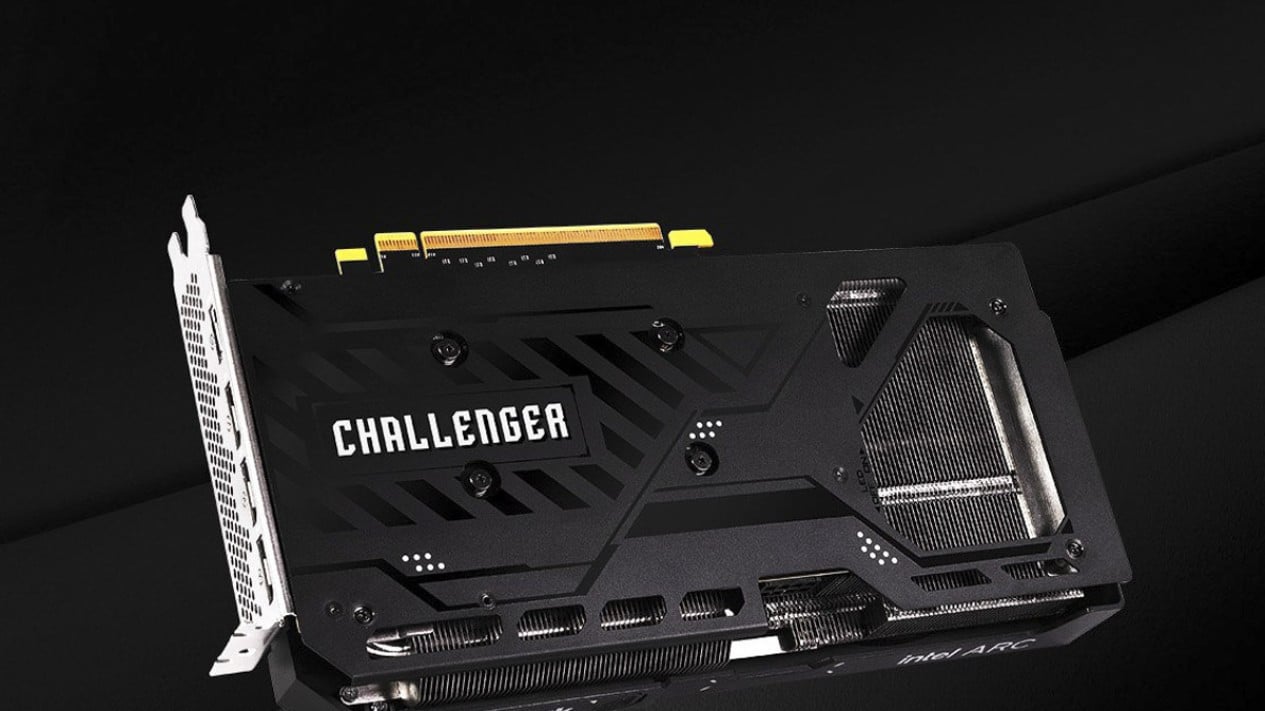
Bagian backplate logam ASRock Intel Arc B580 Challenger 12GB OC yang dibekali memori GDDR6 12GB.
- Dok. ASRock
Peningkatan performa yang signifikan ini bersumber dari perbedaan pengoptimalan instruksi antara Strata versi 0.2.1 dan XeStrata. XeStrata dirancang khusus untuk memaksimalkan jalur eksekusi pada arsitektur GPU Intel. Perangkat lunak ini secara efektif memanfaatkan unit akselerasi Intel Xe Matrix Extensions (XMX) yang tertanam di dalam chipset Arc B580. Hasilnya, throughput pemrosesan teks meningkat tajam saat memproses perintah yang kompleks.
Kendati demikian, hasil ini berfokus pada kecepatan generasi teks atau output throughput. Kecepatan pemrosesan awal (prompt processing), latensi respon pertama, hingga tingkat akurasi jawaban tidak mengalami perubahan drastis hanya karena pergantian mesin inferensi ini.
Peran Krusial Memori Sistem dalam Teknik Offloading AI
Secara teknis, memori VRAM sebesar 12GB GDDR6 pada Intel Arc B580 tentu tidak akan sanggup menampung keseluruhan bobot data dari model AI berkapasitas 125B. Di sinilah arsitektur XeStrata memainkan peran kuncinya. Mesin ini mengandalkan teknik offloading yang membagi beban kerja antara memori grafis dan memori utama komputer (system RAM).
Sistem pengujian tersebut mengombinasikan Intel Arc B580 dengan prosesor Intel Core Ultra 5 250KF Plus dan RAM DDR5 sebesar 64GB di atas sistem operasi Ubuntu 26.04 LTS. Berdasarkan dokumentasi teknis, model Qwen3.8 dengan kuantisasi IQ3_S membutuhkan alokasi RAM sistem sekitar 50GB. Artinya, keberadaan RAM 64GB menjadi syarat mutlak agar model raksasa ini dapat berjalan. Kartu grafis berfungsi sebagai akselerator pemrosesan angka, sementara RAM menampung sebagian besar parameter model.
Bagi para penggiat AI lokal di Tanah Air yang memiliki anggaran terbatas, informasi ini sangat berharga. Membeli GPU dengan VRAM menengah seperti 12GB tetap memungkinkan untuk menjalankan model LLM berukuran besar, asalkan dibarengi dengan kapasitas RAM sistem yang sangat lapang.
Keterbatasan dan Catatan Teknis yang Perlu Diperhatikan
Meskipun hasil 31,1 tokens per second terlihat mengesankan untuk kartu grafis kelas menengah, ada beberapa catatan penting sebelum Anda merakit PC AI serupa. Penggunaan kartu grafis 12GB dengan bantuan RAM offloading masih memiliki keterbatasan saat dihadapkan pada alur kerja berbasis agen (agentic workflows) yang terintegrasi secara intensif.
Beban kerja yang membutuhkan manipulasi data secara terus-menerus tetap memerlukan kartu grafis dengan VRAM murni yang lebih besar serta bandwidth memori lebih tinggi. Selain itu, kompatibilitas driver pada lingkungan Linux juga memegang peranan penting. Rilis perangkat lunak XeStrata versi terbaru melaporkan adanya fluktuasi performa akibat interaksi driver GPU Intel tertentu pada kernel Linux.
Oleh karena itu, angka pemrosesan 31,1 token per detik ini sebaiknya tidak dijadikan sebagai tolok ukur mutlak untuk seluruh konfigurasi sistem. Hasil pengujian ini lebih tepat dipandang sebagai bukti nyata bahwa ekosistem perangkat lunak dapat mendongkrak kemampuan perangkat keras ke titik maksimalnya.
Menimbang Relevansi Intel Arc B580 untuk Sistem AI Lokal
Bagi pengguna yang ingin membangun rig AI lokal berbiaya terjangkau, Intel Arc B580 menawarkan potensi yang sangat menarik. Sinergi antara akomodasi hardware dan mesin inferensi yang tepat dapat memangkas kebutuhan investasi GPU kelas atas yang harganya melambung tinggi.
Berikut adalah beberapa poin pertimbangan sebelum Anda memilih konfigurasi ini:
- Keunggulan Utama:
- Dukungan unit akselerasi Intel XMX yang terbukti responsif pada mesin inferensi modern seperti XeStrata.
- Mampu menjalankan model LLM raksasa hingga 125B melalui teknik RAM offloading.
- Efisiensi biaya perangkat keras yang tinggi untuk kebutuhan generative AI tingkat pemula hingga menengah.
- Catatan Keterbatasan Teknis:
- Membutuhkan RAM sistem DDR5 berkapasitas besar (minimal 64GB) yang menambah biaya rakitan PC.
- Kecepatan pemrosesan sangat bergantung pada optimasi driver dan kompatibilitas sistem operasi Linux.
- Tidak disarankan untuk alur kerja AI tingkat lanjut yang membutuhkan VRAM fisik berkapasitas besar.